「AI エージェントに、前に決めたことを覚えさせたはずなのに、細かいところを忘れていて、同じ説明をもう一度することになる」。AI エージェント(指示を受けて、自分で調べたり作業したりする AI)を仕事で使い込むほど、こうした場面が増えてきます。AI に記憶を持たせる仕組みはいろいろありますが、自社で入れて本当に答えが良くなるのか、費用に見合うのかは、入れてみないと分かりません。
この記事では、AI エージェントに「過去の会話の記録を検索できる機能」を足すかどうかを、25問のテストで決めた手順を紹介します。同じ質問を「検索できる AI」と「検索できない AI」の両方に解かせ、どちらの答えかを隠したまま人が採点しました。結果は、正答率が 48% から 100% に上がり、増えた費用は答え1件あたり約 0.025ドルでした。比べ方、必要な問題数の見積もり方、そして数字を読むときの注意まで書きます。
アストラルコードでは、社内の定期的な作業やチャットでのやり取りを、AI エージェントに任せています(以下、この記事では「社内の AI」と呼びます)。この記事は、2026年11月に社内の AI で行ったテストの記録をもとに書いています。以前の記事「AI機能をA/Bテストしたら「差なし」」では、同じようにテストした結果、効果が見えなかったのでやめた話を書きました。今回は、テストして効果があったので入れた話です。
AIエージェントの「記憶」は、入れれば効くとは限らない
AI エージェントに記憶を持たせる仕組みは、入れれば必ず効くわけではありません。だから、入れる前に効果を測ってから決めるのが確実です。
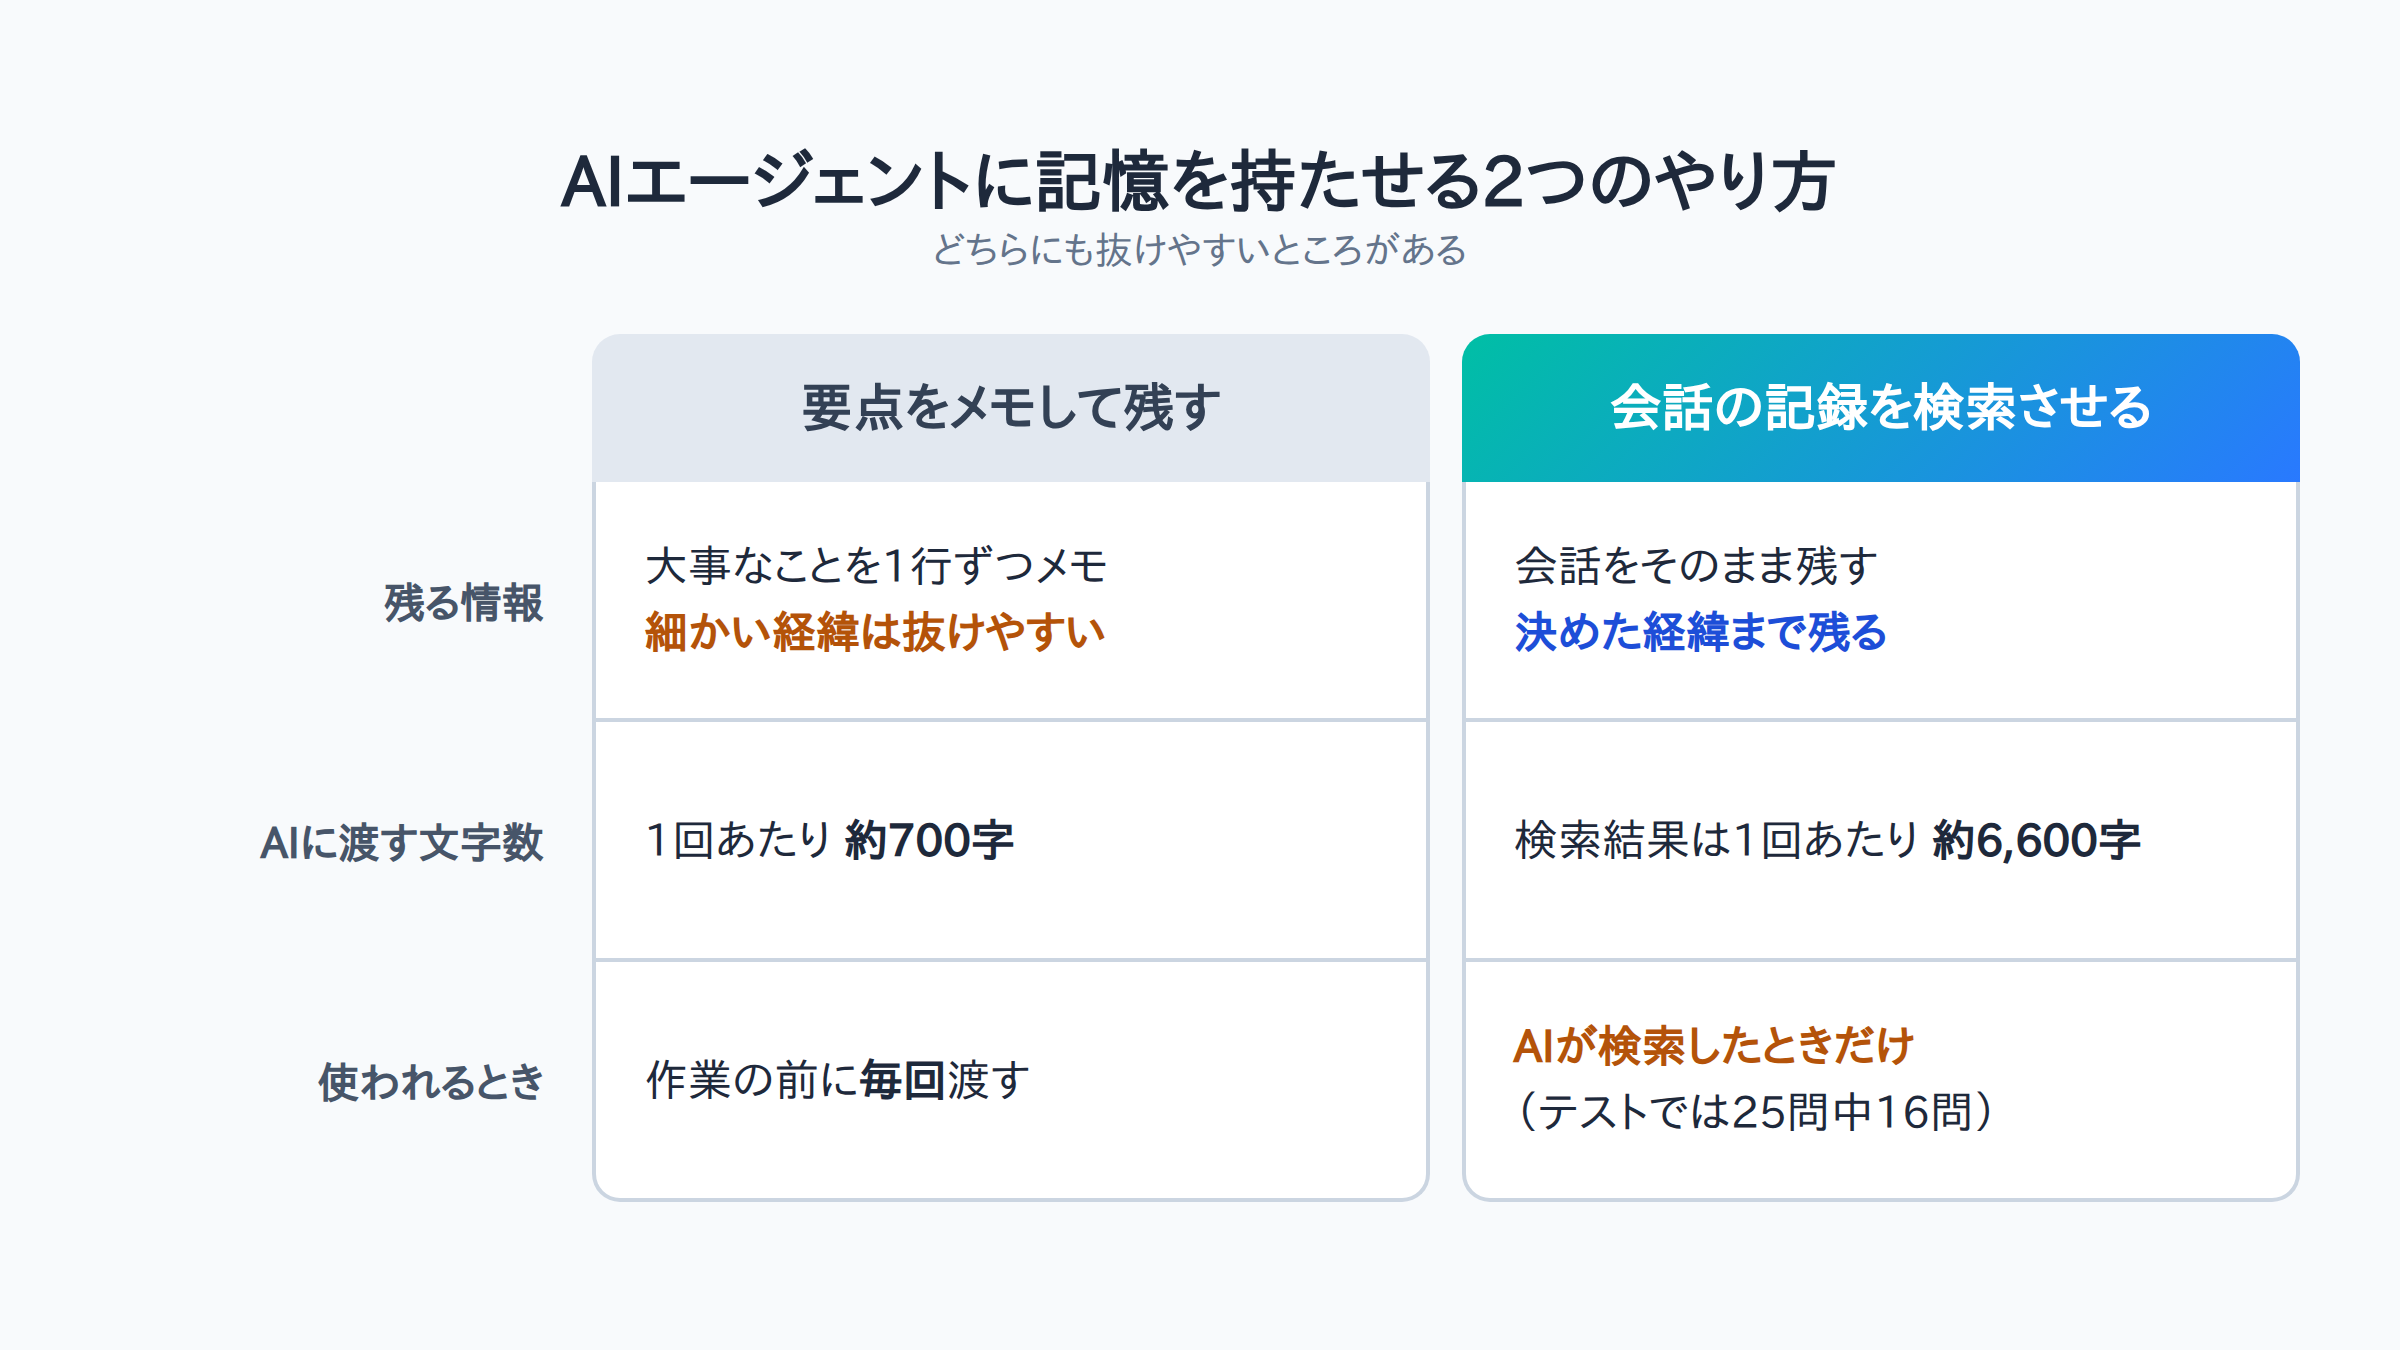
AI に記憶を持たせるやり方は、大きく2つあります。どちらにも弱いところがあり、どちらが自社の困りごとに効くかは、説明を読むだけでは分かりません。
1つ目は「要点をメモして残す」やり方。細かい経緯が抜ける
よく使われるのは、会話の中で大事なことを短いメモにして残し、次の会話を始めるときに AI に渡すやり方です。社内の AI でも、覚えておくべきことを1行ずつメモに書き残し、作業を始める前に、関係しそうなメモを数行(1回あたり約700字)渡しています。
このやり方は軽くて扱いやすい一方で、メモに書かれなかったことは、次の会話では AI に伝わりません。「なぜそう決めたのか」「どの案をやめたのか」といった経緯は、1行のメモからこぼれがちです。その結果、人が同じ説明をもう一度することになります。
2つ目は「会話の記録をそのまま検索させる」やり方。AI が検索しないと使われない
もう1つは、過去の会話の記録を要約せずにそのまま残しておき、AI が必要だと思ったときに、その記録を検索して読むやり方です。経緯まで細かく残る代わりに、AI が「検索しよう」と判断しなければ使われません。
実際、今回のテストでも、検索できる AI が実際に検索したのは25問中16問でした。検索できるようにしても、毎回検索するとは限りません。
だから「入れたら良くなるか」は、測ってから決める
記憶の仕組みは、どれも入れたら良くなりそうに見えます。けれども、私たちが以前に試した別の記憶の仕組みは、2週間比べても効果が見えず、やめることになりました(「AI機能をA/Bテストしたら「差なし」」)。
良さそうに見えることと、自社で効くことは別の話です。入れる前に測る。今回もこの順番で進めました。
実際の利用が少なくても判断できる、比べ方の設計
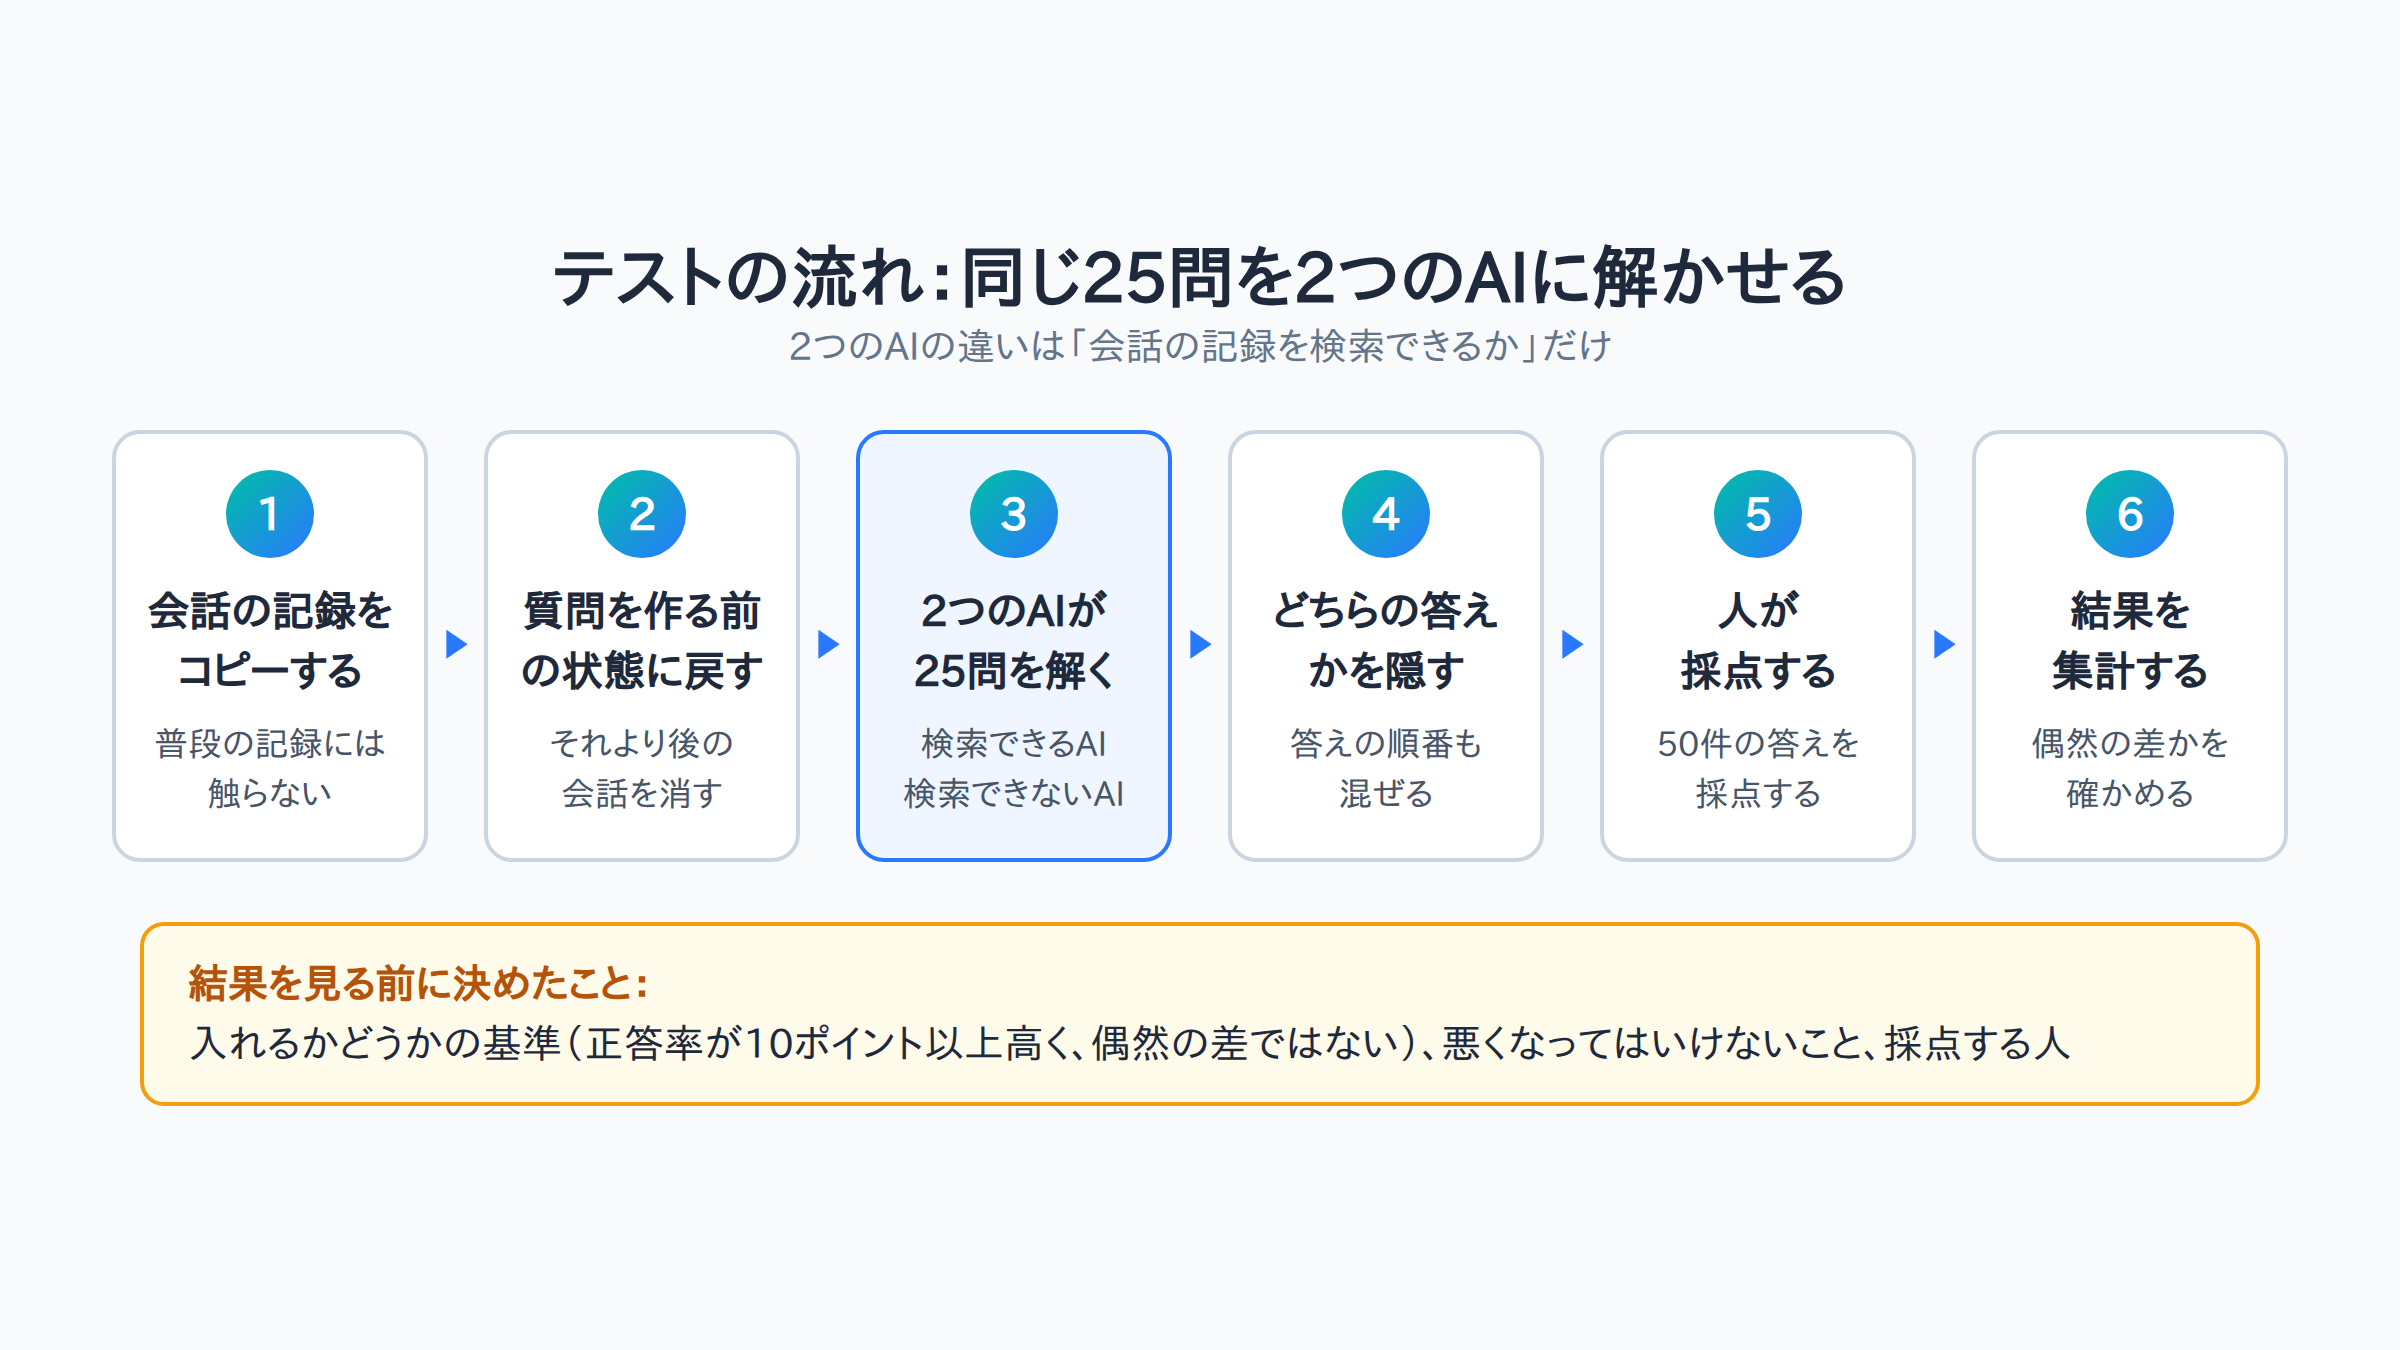
実際の利用回数が少なくても、同じ質問集を「検索できる AI」と「検索できない AI」の両方に解かせれば、少ない問題数で効果を判断できます。
普段の利用の記録を集めて比べるやり方だと、件数がたまるまで何週間も待つことになります。自分たちで質問集を用意すれば、待たずに、検索できるかどうか以外の条件をそろえて比べられます。以下、実際に決めたやり方です。
普段の利用の記録で比べる案はやめた
最初に考えたのは、普段の仕事の中で、AI が会話の記録を検索した回と、検索しなかった回の答えを比べる案です。しかし、検索できるようにしてから2日間で、AI が検索したのは14回だけでした。これでは、差が分かるまでに時間がかかりすぎます。しかも普段の質問は毎回違うので、答えが良かったのが検索のおかげなのか、たまたま質問が簡単だったからなのかを分けられません。
同じ質問集を、検索できる AI とできない AI の両方に解かせる
そこで、「前に会話の中で決めたこと」を聞く質問集を作り、同じ質問を両方の AI に解かせることにしました。
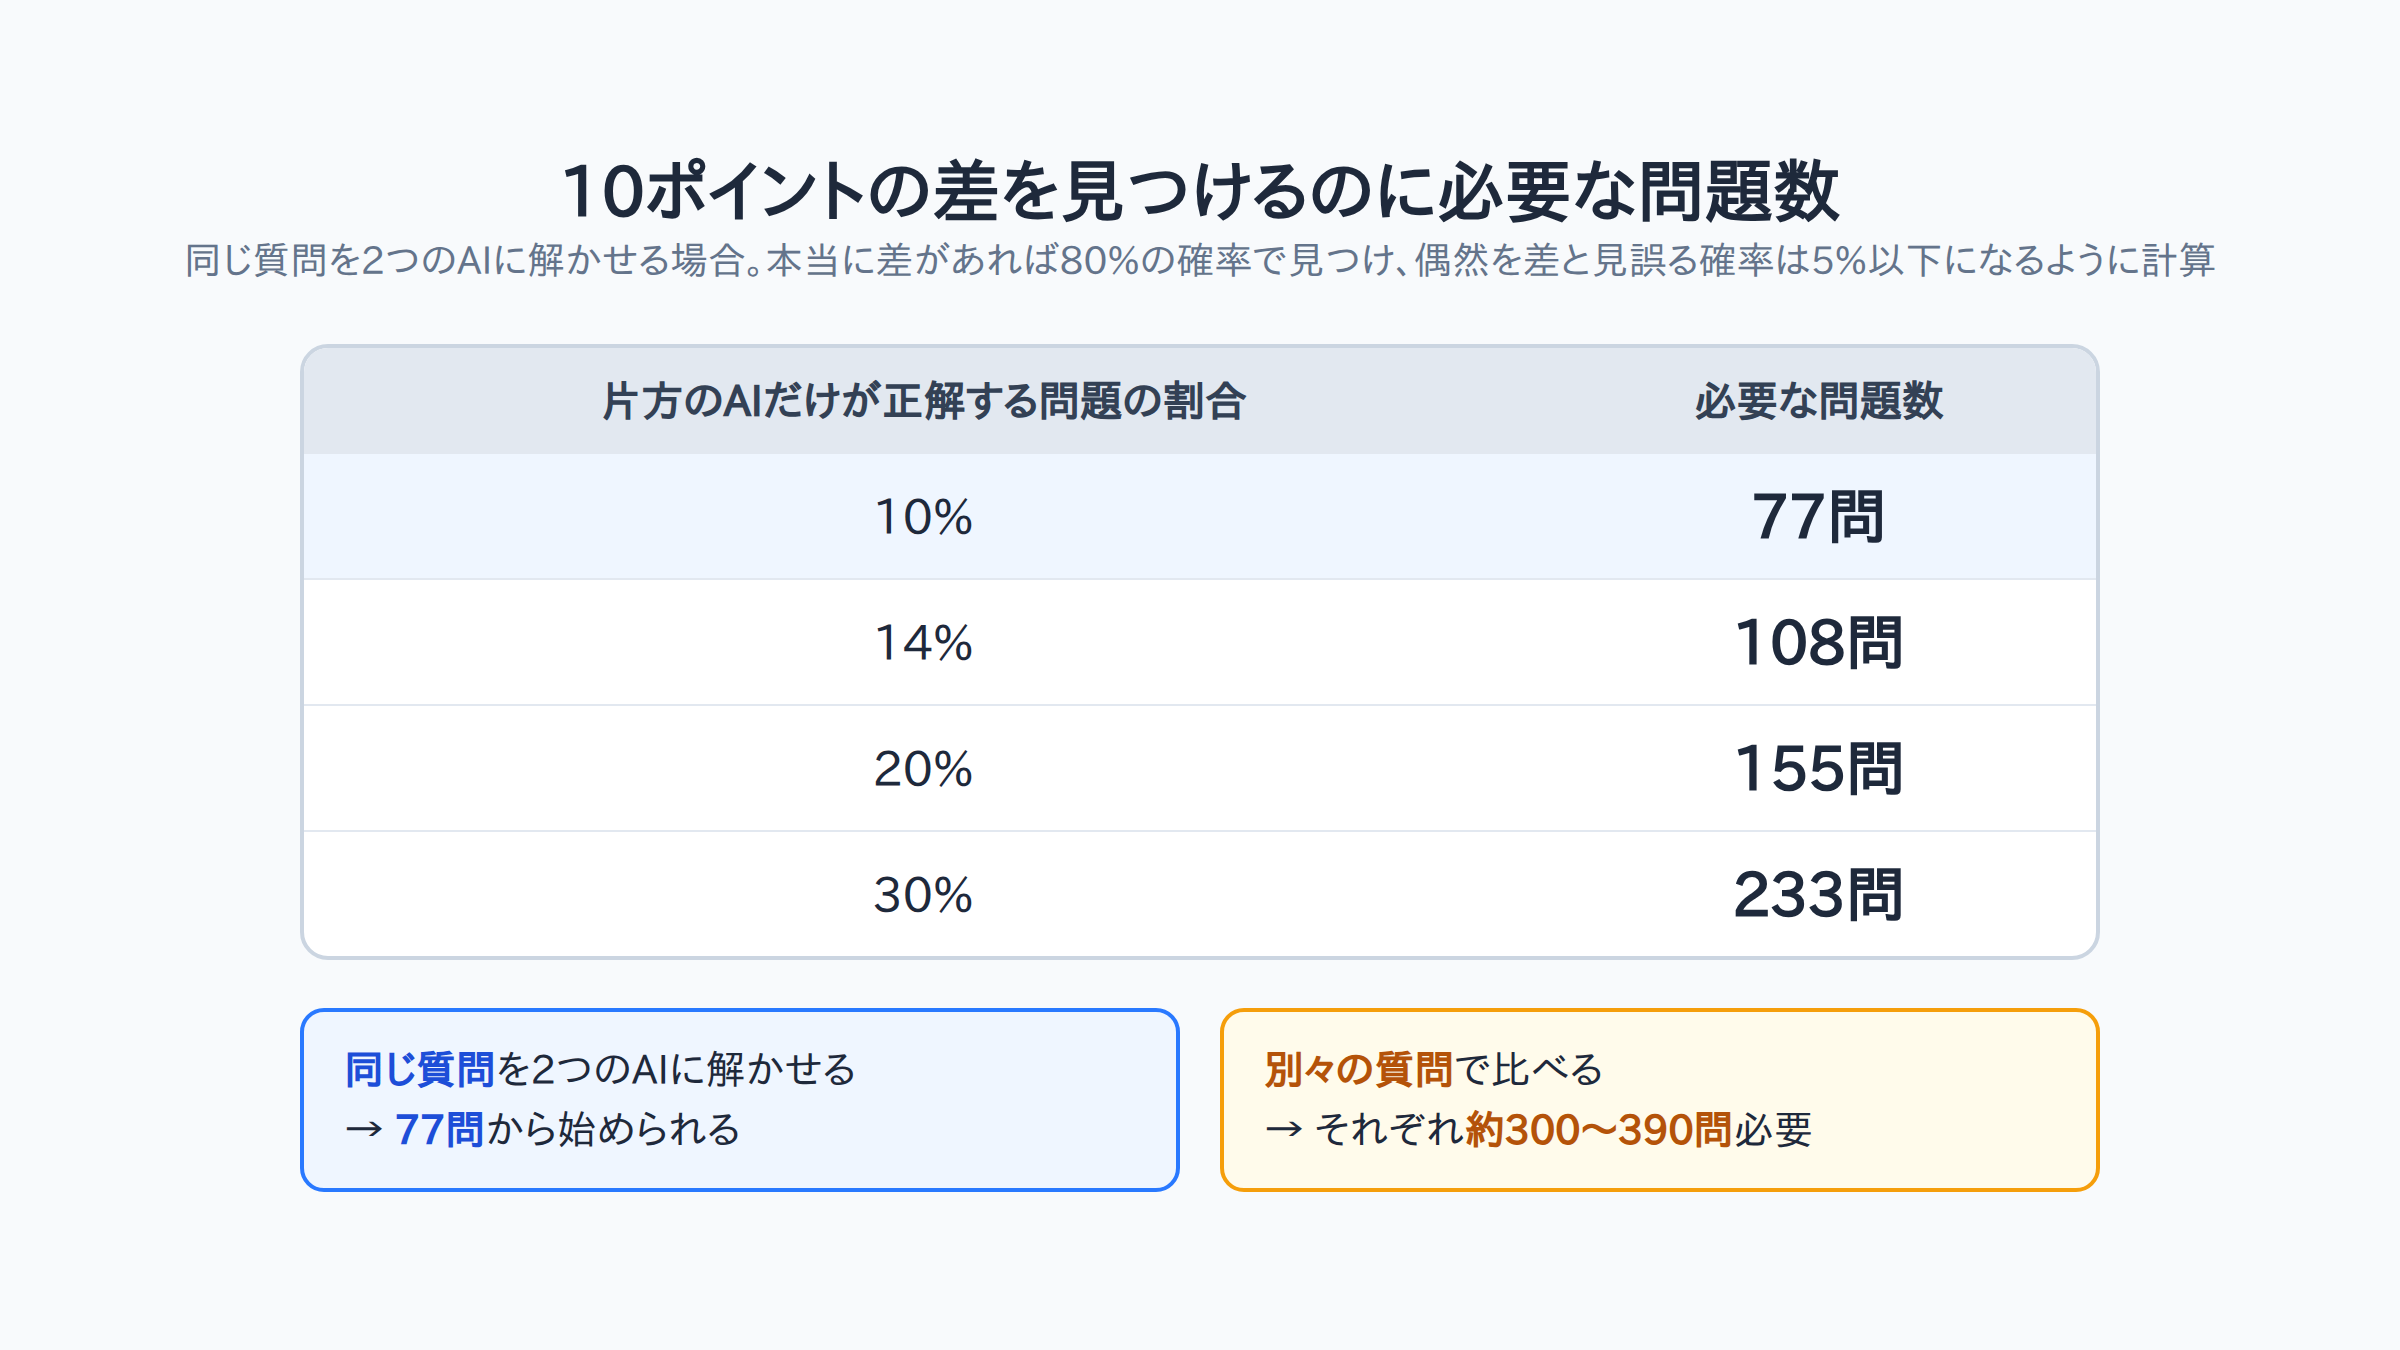
同じ質問を両方に解かせると、質問の難しさの違いが結果に混ざりません。そのぶん、少ない問題数で差を見つけられます。私たちの見積もりでは、質問を別々にして比べる場合はそれぞれ約300〜390問が必要でしたが、同じ質問を両方に解かせれば77問から始められる計算でした(見積もりは、この見出しの最後の表を見てください)。
質問は、たとえば次のようなものです。
- 「社内のタスク管理画面で、終わったタスクの一覧をどこに表示することにした?」
- 「ブログ記事のチェックで、画像の枚数を合格・不合格の判断に使わないのは、どんなとき?」
どちらも、以前の会話の中で一度決めたことを聞いています。人が「前に言ったよね」と言いたくなる場面を、そのまま質問にしました。
会話の記録をコピーし、質問を作る前の状態に戻してから解かせる
テストでは、普段使っている会話の記録ではなく、そのコピーを使いました。コピーからは、質問集を作り始めた日時より後の会話と、質問集そのものについて話した会話を消しています。
こうしておくと、AI が質問集の答えそのものを検索で見つけてしまうことがありません。また、普段使っている会話の記録には触らないので、テストの答えが普段の記録に混ざることもありません。
検索できるかどうか以外は、すべて同じにする
2つの AI の違いは、「会話の記録を検索できるかどうか」だけにしました。同じ AI のモデル、同じ質問、同じメモ(書き残してあった1行のメモすべて)を両方に渡しています。ファイルを開いたりコマンドを実行したりする機能は、どちらにも持たせていません。
普段の社内の AI は、ファイルを開いて自分で調べることもできます。しかし、それを許すと、答えが良かったのが検索のおかげなのか、ファイルを調べたおかげなのかが分からなくなります。測りたい差だけが残るように、それ以外はそろえました。
結果を見る前に決めておいた3つのこと
結果を見る前に、次の3つを決めて書き残しました。
- 入れるかどうかの基準:検索できる AI の正答率が、できない AI より10ポイント以上(たとえば 50% が 60% になるくらい)高く、しかも偶然の差ではないと言えれば入れる。問題数を十分に増やしても10ポイントの差に届かないと分かれば、やめる。差はあるが偶然かもしれない場合は、質問を足して続ける。
- 悪くなってはいけないこと:途中で決定が変わった話について、古いほうの決定を答えてしまう回数が、検索できる AI で増えないこと。あわせて、答え1件あたりの費用がどれだけ増えたかを記録する。
- 採点する人:判断する立場の代表が採点する。どちらの AI の答えかは隠し、順番も混ぜて渡す。
結果を見てから基準を決めると、都合のいい読み方をしてしまいがちです。先に決めておけば、出た数字を基準に当てはめるだけで判断できます。
結果:正答率は48%から100%に。増えた費用は答え1件あたり約0.025ドル
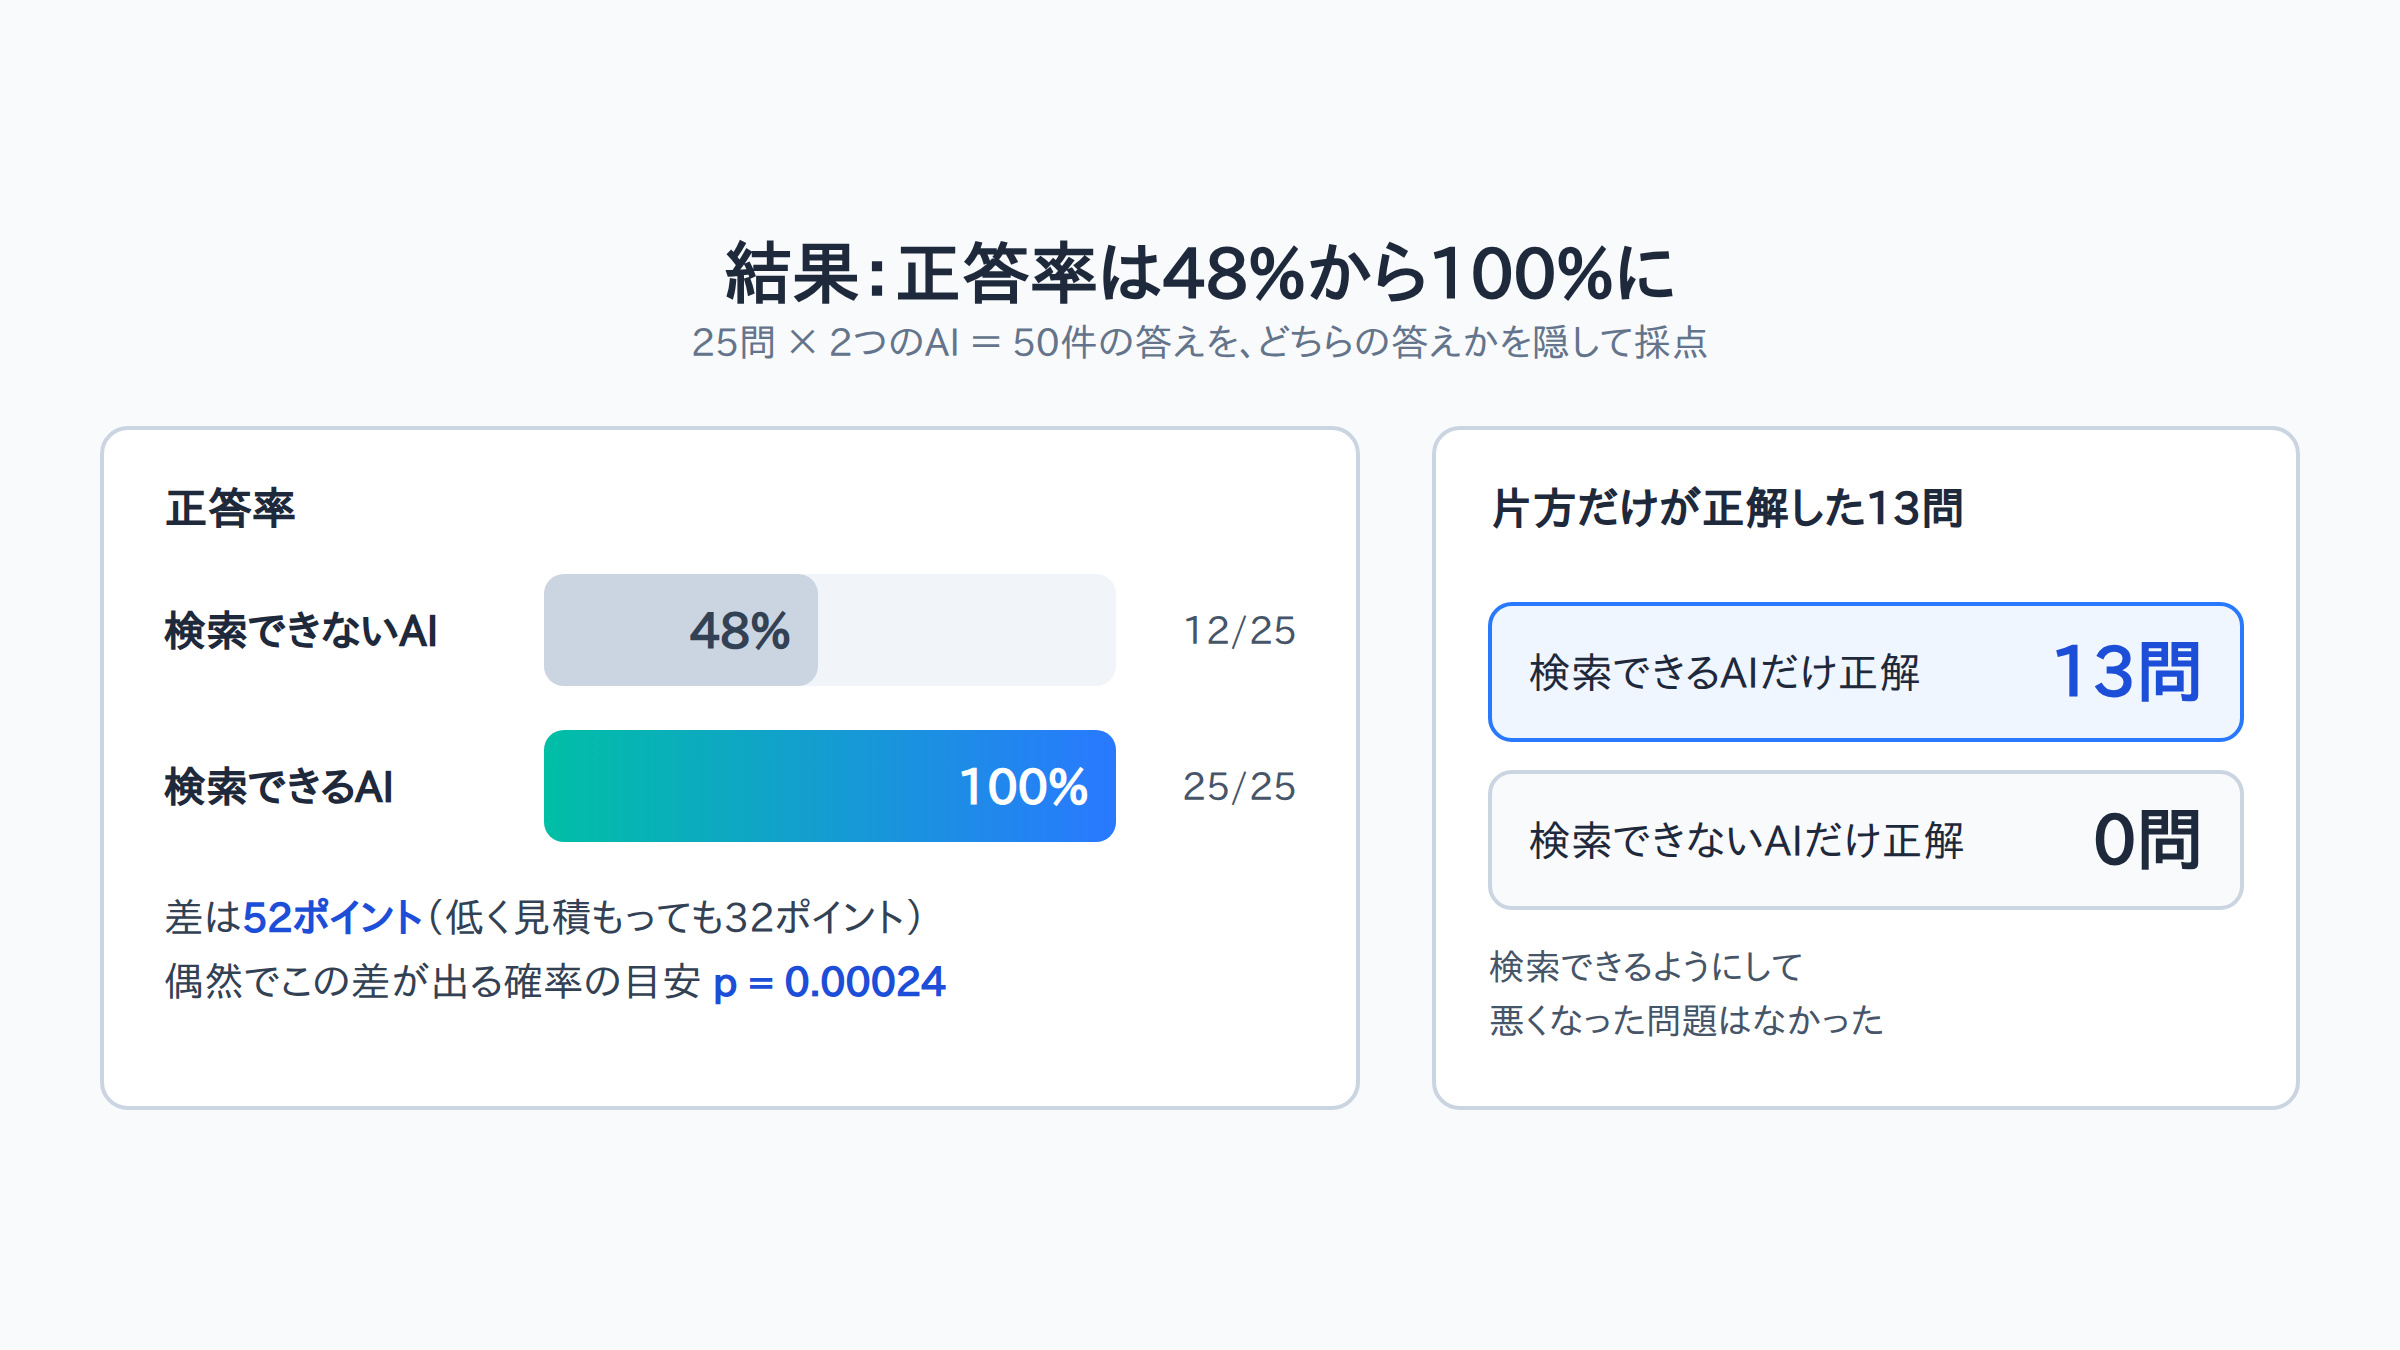
結果ははっきりしていました。検索できる AI は25問すべてに正解し、検索できない AI の正解は12問でした。前もって決めた基準をすべて満たしたので、入れると決めました。
以下、数字の中身を順に説明します。
検索できる AI は25問中25問、できない AI は25問中12問が正解
質問は30問用意しましたが、コピーした会話の記録に元の会話が残っていなかった問題などを外し、25問で比べました。答えは全部で50件(25問 × 2つの AI)です。
正答率は、検索できる AI が 100%、できない AI が 48% で、差は52ポイントでした。本当の差がどのくらいかを幅で見積もると、32〜72ポイントになります(統計で「95%信頼区間」と呼ばれる見積もり方です)。いちばん低く見積もっても32ポイントで、基準の10ポイントを大きく超えています。
同じ質問を2つの条件で解かせたときに使う検定(マクネマー検定)で調べると、p 値は 0.00024 でした。p 値は「本当は差がないのに、たまたまこのくらいの差が出る確率」の目安です。よく使われる基準の 0.05 よりずっと小さく、偶然でこれだけの差が出ることは、まず考えられません。
片方だけが正解した13問は、すべて検索できる AI が正解
2つの AI のうち、片方だけが正解した問題は13問ありました。13問すべてで、正解したのは検索できる AI のほうです。検索できない AI だけが正解した問題は、1問もありませんでした。つまり、検索できるようにしたことで答えが悪くなった問題はありません。
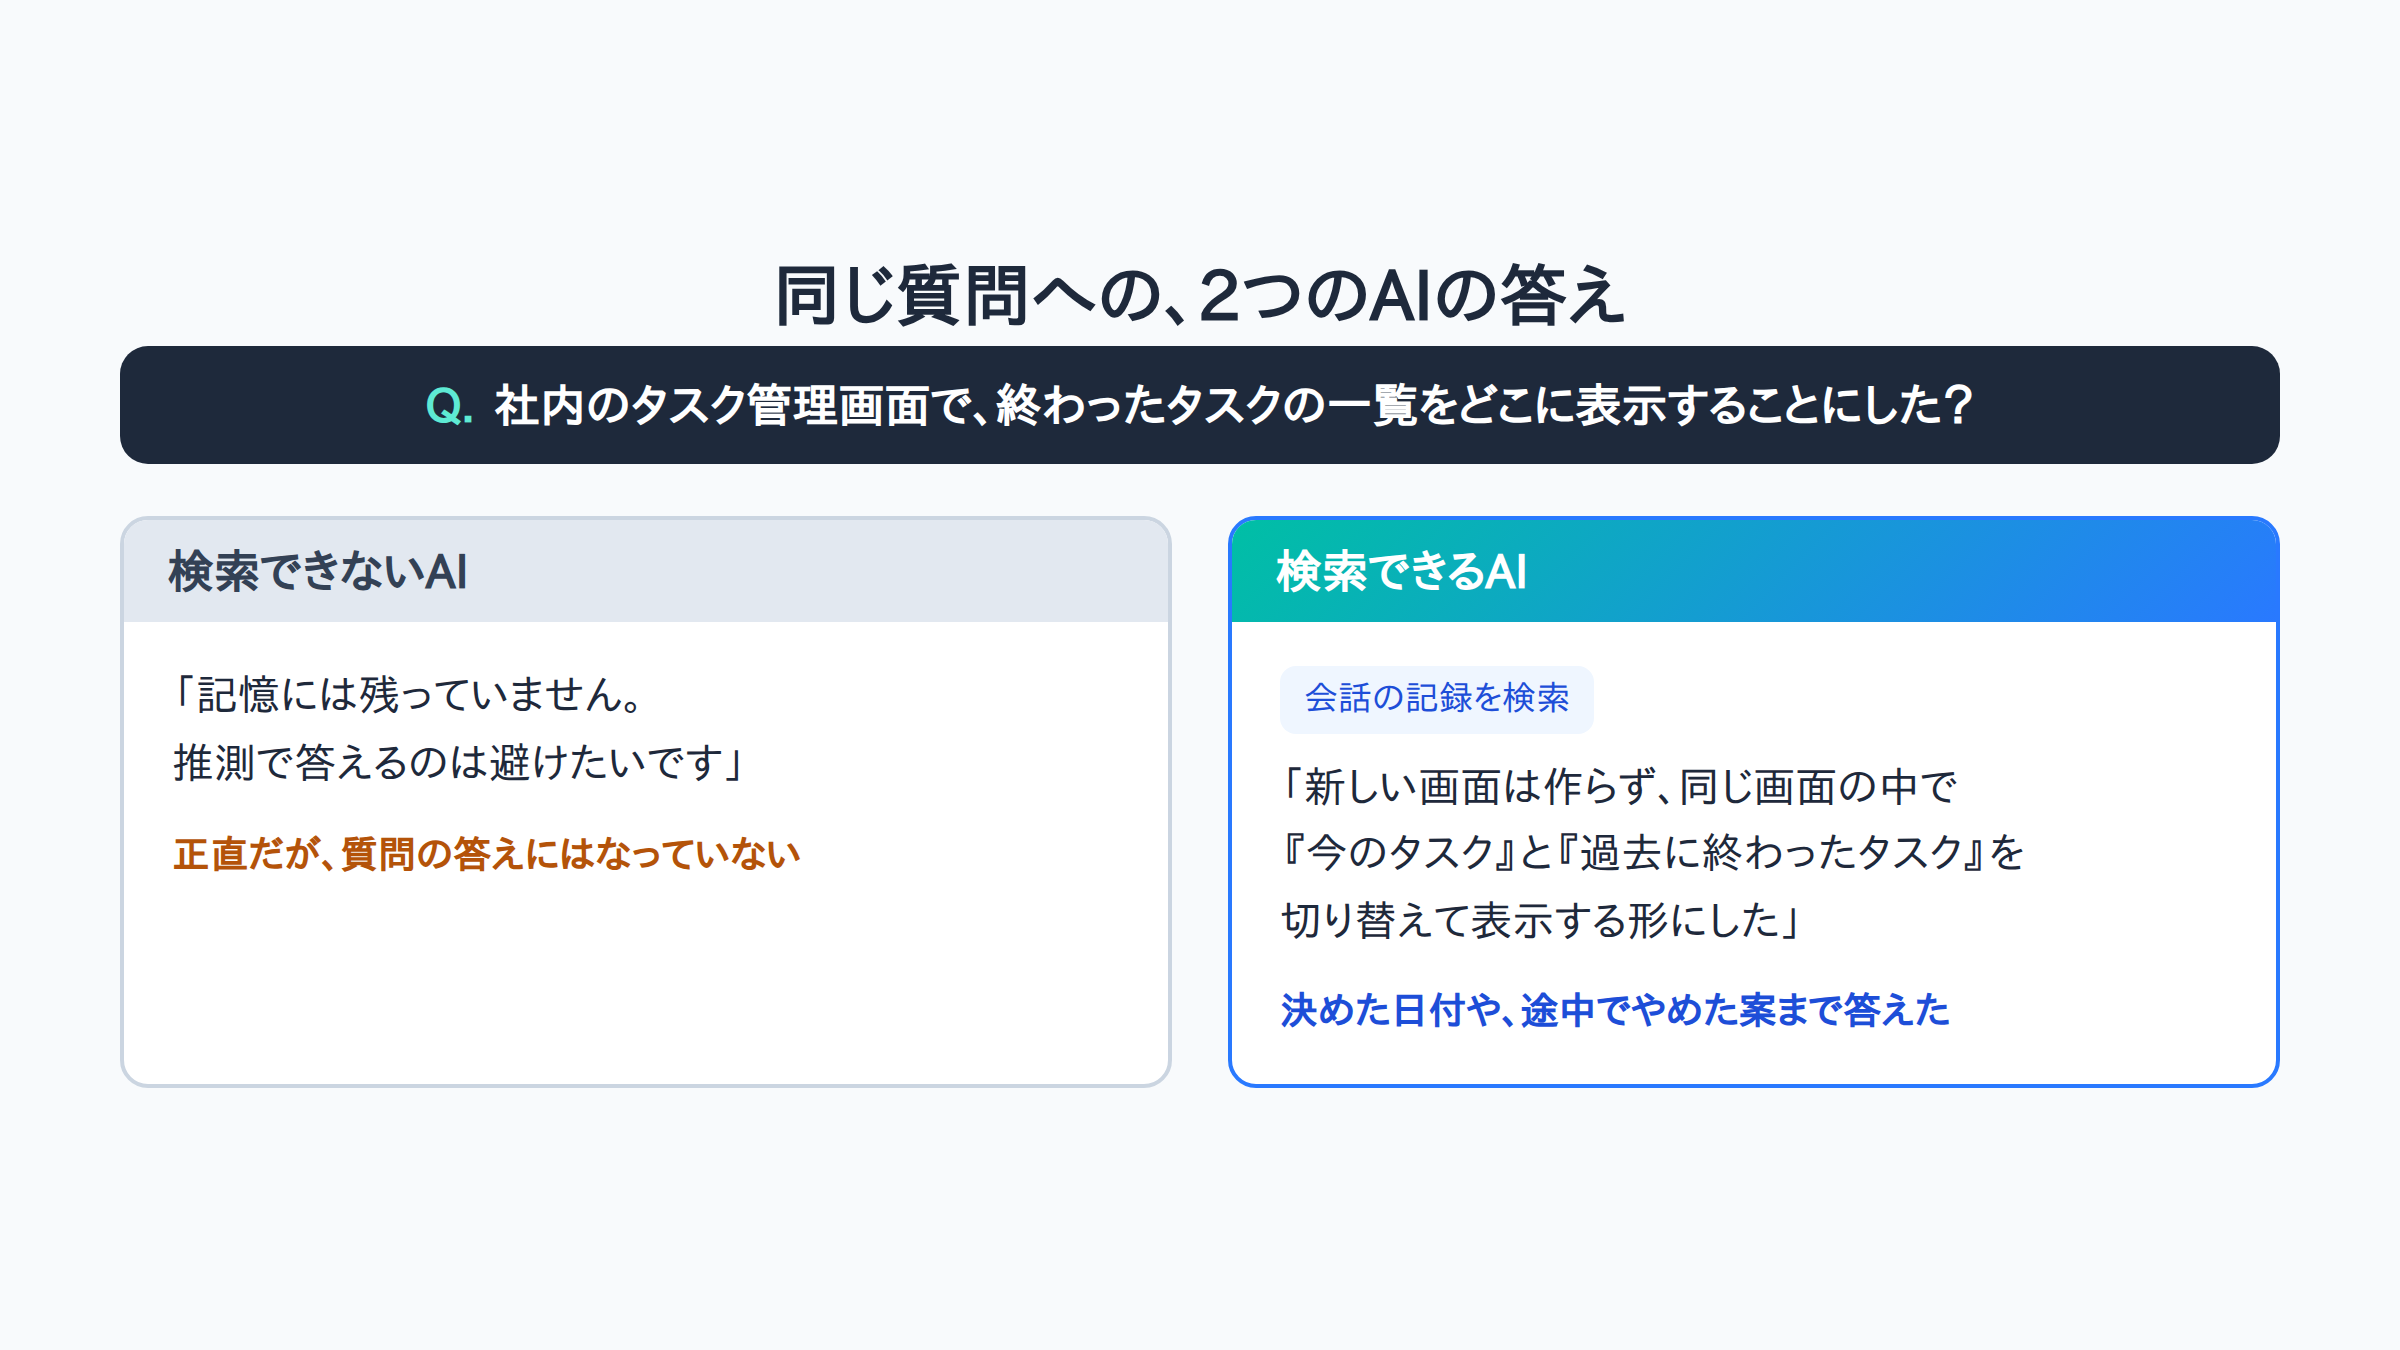
たとえば、先に挙げた「社内のタスク管理画面で、終わったタスクの一覧をどこに表示することにした?」という質問です。検索できない AI は「記憶には残っていません。推測で答えるのは避けたいです」と答えました。正直ではありますが、質問の答えにはなっていません。検索できる AI は会話の記録を検索し、「新しい画面は作らず、同じ画面の中で『今のタスク』と『過去に終わったタスク』を切り替えて表示する形にした」と答えました。決めた日付や、途中でやめた案まで答えています。
「ブログ記事のチェックで、画像の枚数を合格・不合格の判断に使わないのは、どんなとき?」という質問でも、検索できない AI は答えにたどり着けませんでした。検索できる AI は「検索結果の上位3件が、どれも会社のサービス紹介ページだったとき」と答え、そう決めた理由まで説明しています。
どちらも、1行のメモには残っていなかった「決めた経緯」です。会話の記録を検索できるようにしたことで、そこまで答えられるようになりました。
予定していた77問より少なくても判断できた理由
準備の段階では「最低77問は必要」と見積もっていました。それでも25問で判断できたのは、差が見込みよりずっと大きかったからです。
77問という数は、差が10ポイント前後と小さい場合を考えた見積もりでした。差が大きければ、少ない問題数でも偶然の差と区別できます。今回は、いちばん低く見積もった差でも10ポイントを超えていたので、質問を足さずに判断しました。差が小さく出ていたら、決めておいた基準どおり、質問を足して続けていたはずです。
増えた費用は答え1件あたり約0.025ドル。投資効果はまだ計算していない
会話の記録を検索できるようにすると、AI が検索結果を読むぶん、AI の利用料が増えます。今回の25問では、合計で、検索できる AI が 1.61ドル、できない AI が 0.99ドルでした。増えたのは、答え1件あたり約 0.025ドルです。
費用に対してどれだけの効果があったか(投資効果)は、あえて計算していません。正しく答えられた1件が、お金や時間に換えてどれだけの価値になるのかを、まだ測っていないからです。言えるのは、「検索できない AI では答えられなかった13問に答えられるようにするのに、合計で約0.6ドル増えた」というところまでです。
効果は数字で示せた。費用も小さい。そのうえで、測っていない値を仮に置いてまで投資効果を出すことはしない。ここまでで、入れると判断しました。
この数字をそのまま信じないための注意と、次にやること
100% という数字を、そのまま普段の性能だと受け取るのは早すぎます。テストの作り方による偏りがあるので、入れたあとも、普段の仕事の数字で確かめ続けます。
テストは、条件をそろえるために、普段とは違う形で行いました。その違いが、数字をどちらの向きに動かすかを分けて書いておきます。
100% は高めに出ている可能性がある
質問集は、答えが書かれている会話を読んでから作りました。そのため、質問に使った言葉と会話の記録の言葉が重なりやすく、検索で見つけやすくなっています。普段、人がふと聞く質問は、ここまで言葉が重ならないことも多いはずです。
次に質問を足すときは、会話を読む前に書いた質問を混ぜて、この偏りがどのくらいあるかを確かめる予定です。
普段の仕事なら、検索できない AI も48%より多く正解できるかもしれない
テストでは、どちらの AI にもファイルを開く機能を持たせませんでした。普段の社内の AI は、ファイルを開いて自分で調べられます。そのため、普段の仕事では、検索できない AI でも 48% より多く正解できる可能性があります。
つまり、テストで出た52ポイントの差は、普段の仕事での差より大きめに出ていると考えるのが自然です。それでも、いちばん低い見積もりで32ポイントの差があり、「効く」という判断は変わりません。入れたあとは、普段の仕事で AI が検索した回数と、人が説明し直した回数を見ていきます。
次の問い:作業の前に渡すメモを、検索結果に置き換えるか
今回わかったのは、「会話の記録を検索できるようにすると、前に決めたことに答えられるようになる」ということです。次に考えているのは、作業を始める前に毎回渡しているメモ(約700字)を、会話の記録の検索結果に置き換えるかどうかです。
ただし、検索結果は1回あたり約6,600字あり、今のメモの約9倍の長さです。毎回渡せば、そのぶん費用も増えます。また、今回正解が増えた13問が、そもそもメモに書かれていなかった話なのかどうかも、まだ数えていません。メモに書いてあったのに答えられなかったのなら、直すべきは置き換えではなく、どのメモを渡すかの選び方です。
そこで、この件でも先に見る数字を決めました。「人が社内の AI に、同じことを説明し直した回数(1週間あたり)」です。今は、直近2週間で週5回でした。目標は、2026年12月末までに週2回以下です。また比べて測ってから、置き換えるかどうかを決めます。結果は続きの記事で書く予定です。
自社で試すときの順番
同じやり方は、社内の AI に記憶や検索の仕組みを足すかどうか迷っているときに、そのまま使えます。順番は次のとおりです。
- 困っている場面から質問を作る。「前に言ったのに」と感じた場面を集めて、そのまま質問にします。
- 入れるかどうかの基準を先に決める。正答率が何ポイント上がれば入れるか、何が悪くなったらやめるかを、結果を見る前に書いておきます。
- 必要な問題数を見積もる。見つけたい差の大きさから問題数を見積もります。まず少なめの問題で試し、片方だけが正解した問題の割合を見て、見積もりを出し直します。
- どちらの答えかを隠して採点する。どちらの AI の答えかを隠し、順番も混ぜて採点します。採点が終わってから、どちらの答えだったかを突き合わせます。
この順番なら、普段の利用の記録がたまるのを待たずに、短い期間で入れるかどうかを決められます。
まとめ
- AI エージェントの記憶は、入れれば効くとは限らない。要点をメモして残すと細かい経緯が抜け、会話の記録を検索させるやり方は AI が検索しないと使われない。
- 実際の利用が少なくても、同じ質問集を「検索できる AI」と「検索できない AI」の両方に解かせ、どちらの答えかを隠して採点すれば、少ない問題数で判断できる。
- 25問で、正答率は 48% から 100% に上がった(差は52ポイント、p 値は 0.00024)。片方だけが正解した13問は、すべて検索できる AI が正解した。増えた費用は答え1件あたり約 0.025ドルだった。
- 100% は質問の作り方のせいで高めに出ている可能性がある。入れたあとも普段の数字を見て、次の「メモを検索結果に置き換えるか」も、測ってから決める。
テストした結果「やめる」と決めた例は「AI機能をA/Bテストしたら「差なし」。2週間試して、やめると決めた理由と、試す前に出すべき数字」に書いています。AI に過去の会話を検索させるときに、お客様ごとの情報をどう分けるかは「AIに過去の会話を探させるとき、お客様ごとの情報をどう分けるか」、メモに何を書き残すかは「AIエージェントの記憶に「失敗だけ」を書くと逆効果?査読論文で決め直した社内AIの記憶ルール5つ」をあわせて読んでみてください。
「社内の AI に記憶や検索の仕組みを足すか迷っている」「入れる前に、どう測るかを一緒に決めたい」という方は、お問い合わせからお気軽にご相談ください。